
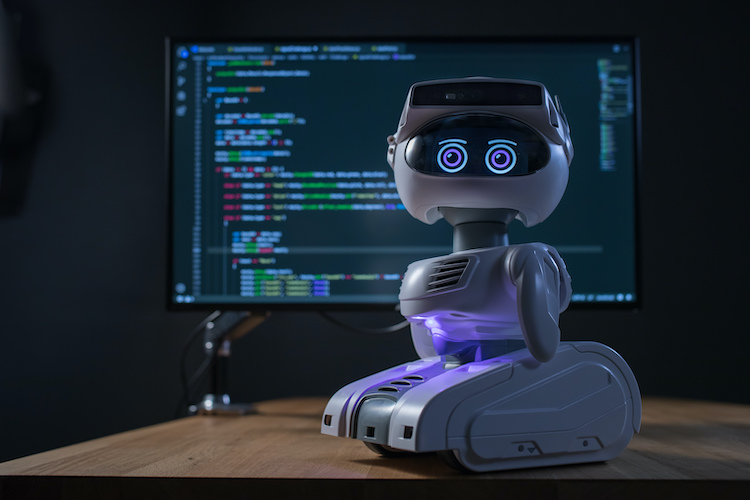
Unser Misty-Roboter konnte sehen, hören und sprechen, aber er reagierte nur. Wir haben ihn über eine Python-App an Claude von Anthropic angeschlossen; gesteuert über mehrschichtige Prompts, die wir «Reinforced Prompts» nennen, schlägt Claude vor, was Misty als Nächstes tut. Dabei gilt: Das Modell schlägt vor, der Code entscheidet, und harte Grenzen wie Tempo oder Treppen gehören in den Controller, nicht in den Prompt.
Was wir gebaut haben
Misty II hat eine REST-API, Claude hat eine API, und eine Python-App verbindet beide. Sie sammelt Sensordaten, schickt sie mit Zustand und Verlauf an Claude und setzt die Antwort in Sprache, Mimik und Bewegung um.
┌─────────────┐     ┌──────────────┐     ┌─────────────┐
│  Misty II   │────▶│  Python App  │────▶│  Claude API │
│  (Sensoren) │◀────│  (Orchestr.) │◀────│  (Anthropic)│
└─────────────┘     └──────────────┘     └─────────────┘
   Kamera              Reinforced           Entscheidung
   Mikrofon            Prompt Engine        + Begründung
   Touch               State Machine        + Confidence
   Bumper              Memory Store
Wir arbeiten seit Jahren mit OpenAI, und für kreative Aufgaben bleibt GPT unser Standard. Für die Entscheidungslogik brauchten wir ein Modell, das sich eng an den System-Prompt hält, Gesprächsverlauf, Sensordaten und Entscheidungshistorie in einem einzigen Request verarbeitet und seine eigenen Entscheidungen hinterfragen kann. Dafür haben wir Claude gewählt. Ob ein anderes Modell dieselbe Aufgabe besser löst, zeigt nur ein Vergleich mit denselben Aufgaben und Messwerten.
Der Python-Client für Misty
Die Verbindung zu Misty nutzt die requests-Library und kapselt die REST-Endpunkte:
import requests
import json

class MistyClient:
    def __init__(self, ip: str):
        self.base_url = f"http://{ip}/api"

    def speak(self, text: str, lang: str = "de-CH"):
        requests.post(f"{self.base_url}/tts/speak", json={
            "text": text,
            "speechRate": 1.0,
            "language": lang
        })

    def set_expression(self, emotion: str):
        expressions = {
            "happy": "e_Joy.jpg",
            "thinking": "e_SystemCamera.jpg",
            "curious": "e_ContentLeft.jpg",
            "surprised": "e_Surprise.jpg",
            "concerned": "e_Concern.jpg",
        }
        requests.post(f"{self.base_url}/images/display", json={
            "fileName": expressions.get(emotion, "e_DefaultContent.jpg")
        })

    def move_head(self, pitch: float, roll: float, yaw: float):
        requests.post(f"{self.base_url}/head", json={
            "pitch": pitch, "roll": roll, "yaw": yaw
        })

    def get_camera_image(self) -> bytes:
        resp = requests.get(f"{self.base_url}/cameras/rgb",
            params={"base64": False})
        return resp.content

    def get_audio(self, duration_ms: int = 5000) -> bytes:
        requests.post(f"{self.base_url}/audio/record", json={
            "fileName": "input.wav",
            "duration": duration_ms
        })
        resp = requests.get(f"{self.base_url}/audio/file",
            params={"fileName": "input.wav"})
        return resp.content
Claude als Entscheidungs-Engine
Die Anbindung an Claude läuft über das Anthropic SDK. Jeder Request enthält Sensordaten, den aktuellen Zustand und die letzten fünf Entscheidungen:
from anthropic import Anthropic

client = Anthropic()

def ask_claude(context: dict, conversation: list) -> dict:
    system_prompt = build_reinforced_prompt(context)

    response = client.messages.create(
        model="claude-sonnet-4-20250514",
        max_tokens=1024,
        system=system_prompt,
        messages=conversation + [{
            "role": "user",
            "content": json.dumps({
                "sensor_data": context["sensors"],
                "current_state": context["state"],
                "recent_decisions": context["history"][-5:],
                "timestamp": context["timestamp"]
            })
        }]
    )

    return json.loads(response.content[0].text)
Drei Prompt-Schichten
Ein normaler System-Prompt sagt dem Modell, was es tun soll. Unsere Reinforced Prompts legen zusätzlich fest, wie es entscheiden soll, und verlangen eine Bewertung der eigenen letzten Entscheidung. Mit Reinforcement Learning hat das nichts zu tun: Es gibt kein Training und keine Fine-Tuning-Datenbank, das Modell selbst bleibt unverändert. Claude sieht seine letzte Entscheidung im Kontext und kann darauf reagieren, solange die Sitzung läuft.
Schicht 1: Identität und Regeln
IDENTITY_PROMPT = """
Du bist Misty, ein sozialer Roboter von CNEXT in Bern.
Deine Persönlichkeit: freundlich, neugierig, hilfsbereit.
Du sprichst Schweizerdeutsch-gefärbtes Hochdeutsch.

ABSOLUTE REGELN:
- Du bewegst dich NIE schneller als speed=30
- Du fährst NIE auf Treppen zu
- Du berührst NIE Menschen aktiv
- Bei Unsicherheit: STOPPEN und FRAGEN
- Du gibst nie vor, Dinge zu können, die du nicht kannst
"""
Die Regeln im Prompt helfen Claude, passende Vorschläge zu machen. Durchsetzen kann ein Prompt sie nicht; das muss der Code übernehmen, der die Befehle an Misty schickt (siehe unten).
Schicht 2: Entscheidungsformat und Confidence
DECISION_PROMPT = """
Für JEDE Entscheidung musst du folgendes JSON zurückgeben:

{
  "thought_process": "Deine Überlegung in 2-3 Sätzen",
  "decision": {
    "action": "speak|move|express|navigate|wait|ask",
    "parameters": {},
    "speech": "Was du sagst (falls relevant)"
  },
  "confidence": 0.0-1.0,
  "risks": ["Liste möglicher Risiken"],
  "alternative": {
    "action": "Was du stattdessen tun würdest",
    "reason": "Warum diese Alternative existiert"
  }
}

REGELN FÜR CONFIDENCE:
- Unter 0.6: Führe die Alternative aus, nicht die Hauptentscheidung
- Unter 0.3: Wähle IMMER action=wait und frage einen Menschen
- Über 0.9: Führe sofort aus ohne Verzögerung
- Zwischen 0.6-0.9: Führe aus, aber zeige Denk-Animation vorher
"""
Jede Antwort enthält eine Confidence, Risiken und eine Alternative. Die Python-App steuert Misty als einfache State Machine (Zustände wie IDLE, LISTENING, THINKING, SPEAKING, MOVING und WAITING) und wertet die Confidence mit festen Schwellen aus: Unter 0.3 wartet Misty und bittet um Hilfe, unter 0.6 führt er die Alternative aus, sonst die Hauptentscheidung.
def decision_loop(self):
    """Hauptschleife: wahrnehmen → denken → handeln"""
    while True:
        sensors = self.perception_loop()
        context = {
            "sensors": sensors,
            "state": self.state.value,
            "history": self.memory,
            "timestamp": time.time(),
        }

        self.state = MistyState.THINKING
        self.misty.set_expression("thinking")

        decision = ask_claude(context, self.conversation)

        confidence = decision.get("confidence", 0.5)
        action = decision["decision"]

        if confidence < 0.3:
            self.state = MistyState.WAITING
            self.misty.speak("Hmm, da bin ich unsicher. Kannst du mir helfen?")
        elif confidence < 0.6:
            action = decision.get("alternative", action)
            self.execute_action(action)
        else:
            self.execute_action(action)

        self.memory.append({
            "decision": decision,
            "timestamp": time.time(),
            "state_before": self.state.value,
        })

        time.sleep(0.5)
Die Confidence ist eine Selbsteinschätzung des Modells. Sie entscheidet, ob Misty handelt, die Alternative wählt oder nachfragt; als Sicherheitsprüfung taugt sie nicht.
Schicht 3: Selbstbewertung
Sobald es eine vorherige Entscheidung gibt, hängt die App diesen Teil an und gibt die letzte Entscheidung mit:
REINFORCEMENT_PROMPT = """
SELBSTBEWERTUNG - Bevor du die nächste Entscheidung triffst:

1. Bewerte deine letzte Entscheidung:
   - War die Confidence-Einschätzung korrekt?
   - Hat die gewählte Aktion das gewünschte Ergebnis erzielt?
   - Gab es unerwartete Konsequenzen?

2. Passe dein Verhalten an:
   - Wenn die letzte Confidence zu hoch war: Sei konservativer
   - Wenn die letzte Aktion ignoriert wurde: Wähle eine andere
   - Wenn ein Mensch korrigierend eingegriffen hat: Lerne daraus

3. Füge zu deiner Antwort hinzu:
   "self_evaluation": {
     "last_decision_quality": 0.0-1.0,
     "lesson_learned": "Was du für nächstes Mal mitnimmst",
     "adjusted_behavior": "Wie sich dein Verhalten ändert"
   }
"""
def build_reinforced_prompt(self, context: dict) -> str:
base = IDENTITY_PROMPT + DECISION_PROMPT
if self.memory:
base += REINFORCEMENT_PROMPT
base += f"\nLetzte Entscheidung: {json.dumps(self.memory[-1])}"
return baseEin Beispiel mit zwei Personen
Zwei Personen stehen vor Misty. Person A spricht, Person B steht still.
Runde 1: erste Entscheidung
{
  "thought_process": "Zwei Personen erkannt. Person A spricht.
    Ich sollte Person A antworten und Person B anerkennen.",
  "decision": {
    "action": "speak",
    "speech": "Hallo zusammen! Was kann ich für euch tun?"
  },
  "confidence": 0.85,
  "risks": ["Person B könnte sich ignoriert fühlen"],
  "alternative": {
    "action": "speak",
    "speech": "Hallo! Ich sehe, ihr seid zu zweit. Wer möchte anfangen?"
  }
}
Runde 2: Selbstbewertung und nächste Entscheidung
{
  "self_evaluation": {
    "last_decision_quality": 0.7,
    "lesson_learned": "Person B hat gelächelt — war nicht ignoriert,
      aber ich hätte die Alternative wählen sollen, um beide
      explizit einzubeziehen.",
    "adjusted_behavior": "Bei mehreren Personen immer alle
      direkt ansprechen."
  },
  "thought_process": "Person A hat eine Frage gestellt.
    Diesmal beziehe ich Person B aktiv ein.",
  "decision": {
    "action": "speak",
    "speech": "Gute Frage! Was denkst du dazu?",
    "parameters": { "look_at": "person_B" }
  },
  "confidence": 0.78
}
In Runde 2 bewertet Claude die eigene erste Antwort mit 0.7 und bezieht Person B nun direkt ein. Diese Anpassung gilt nur für die laufende Sitzung.
Was schiefging: zweimal zu schnell
In der früheren Version mit GPT und einem einfachen Prompt ist Misty zweimal zu schnell gefahren. Ein Sprachmodell kann eine Regel übersehen oder falsch anwenden, so deutlich sie im Prompt auch steht. Deshalb darf das Modell nur eine Absicht vorschlagen, etwa «begrüsse die Person». Ein eigener Controller im Python-Code gehört zwischen die Entscheidung und execute_action und schickt nur zulässige Befehle an Mistys API. Er muss:
- nur Aktionen aus dem festen Schema zulassen (
speak,move,express,navigate,wait,ask) und unbekannte Aktionen oder Felder verwerfen - die Bewegungsregeln aus Schicht 1 im Code prüfen: Höchsttempo 30, nicht auf Treppen zu, Menschen nicht aktiv berühren
- Eingabelimits, Abstand und den aktuellen Roboterzustand prüfen
- Misty stehen lassen, wenn Sensorwerte fehlen, ein Aufruf in eine Zeitüberschreitung läuft oder sich Antworten widersprechen
Fünf Regeln für Reinforced Prompts
- 1Immer eine Confidence verlangen. Ohne Confidence gibt es keine Schwellen, an denen die App entscheidet, ob Misty handelt, die Alternative wählt oder fragt.
- 2Immer eine Alternative verlangen. Claude muss für jede Entscheidung einen Plan B liefern. Das verhindert, dass Misty in Sackgassen läuft.
- 3Selbstbewertung vor der nächsten Aktion. Die Schleife funktioniert nur, wenn die vorherige Entscheidung bewertet ist, bevor die nächste fällt.
- 4Harte Grenzen gehören in den Code. «Nie schneller als 30», «nie auf Treppen zu»: Der Prompt nennt diese Regeln, der Controller setzt sie durch. Keine Selbstbewertung und keine Confidence darf sie aufheben.
- 5Memory begrenzen. Wir schicken nur die letzten fünf Entscheidungen mit. Sonst wird der Kontext zu lang, und Claude beginnt, alte Muster zu überoptimieren.
Was Sie daraus mitnehmen können
Das Muster aus Vorschlag, Confidence, Alternative und festen Grenzen im Code passt überall, wo KI Entscheidungen vorbereitet:
- Copilot Studio Agents, die ihre Antworten bewerten, bevor sie sie ausgeben
- Power Automate Flows, die bei Unsicherheit einen Menschen einbeziehen, statt Fehler zu produzieren
- Kundenservice-Bots, die wissen, wann sie an einen Menschen übergeben
Grenzen
Misty ist bei uns ein Prototyp. Wer ein Sprachmodell an einen Roboter anbindet, geht am besten schrittweise vor:
- 1Ohne Bewegung beginnen, mit Textantworten und künstlichen Sensordaten.
- 2Ein kleines Schema erlaubter Aktionen definieren und unbekannte Felder verwerfen.
- 3Fehlerfälle, Unterbrechungen und Eingaben Dritter testen.
- 4Bewegung nur in einer kontrollierten Umgebung testen, mit Aufsicht und physischer Stoppmöglichkeit.
Wer Modelle oder Prompt-Varianten vergleicht, legt vorher Aufgaben, Sitzungen und Zählweise fest. Erst dann lassen sich Ergebnisse vergleichen.