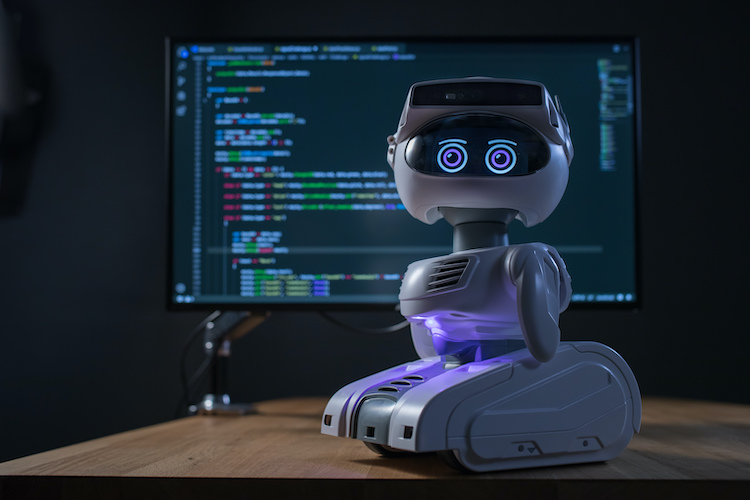
Misty II stellt eine HTTP-API für Bewegung, Anzeige, Audio und Kamera bereit. Ich habe diese Schnittstelle mit Azure Speech, Sprachmodellen von OpenAI und Anthropic und einer festen Zustandsmaschine verbunden, damit Misty zuhört, antwortet, Menschen begrüsst und sie an einen Ort führen kann. Die grössten Hürden waren Lärm, Latenz und die autonome Entscheidungslogik; die wichtigste Lehre betrifft das Design der Interaktion.
Wie das Projekt begann
Ich bin Luis Castillo, Solution Engineer bei CNEXT. Misty war mein Studentenprojekt: CNEXT stellte mir einen Misty II auf den Tisch und sagte: «Mach was draus.»
Misty II ist ein kleiner Roboter mit einem Display als Gesicht, Kameras, Mikrofonen und Touch-Sensoren, der sich selbstständig bewegen kann. Ab Werk spielt er vor allem vorprogrammierte Animationen ab und reagiert auf einfache Befehle. Mein Ziel war ein Roboter, der sieht, hört, versteht, spricht und selbstständig handelt, und zwar mit Sprachmodellen statt mit vorprogrammierten Antworten.
Die Architektur: Das Gehirn liegt in der Cloud
Die wichtigste Designentscheidung: Misty braucht kein Gehirn auf der eigenen Hardware. Der Roboter liefert Sensordaten und führt Befehle aus; Verstehen und Entscheiden übernehmen Cloud-Dienste.
| Fähigkeit | Dienst | Aufgabe |
|---|---|---|
| Hören | Azure Speech-to-Text | Mistys Mikrofone nehmen Sprache auf, Azure wandelt sie in Text um |
| Verstehen und entscheiden | GPT-5 (OpenAI) und Claude Opus (Anthropic) mit System-Prompts | Das Modell entscheidet, ob Misty antwortet, sich bewegt oder eine Emotion zeigt |
| Sprechen | OpenAI TTS und Azure Text-to-Speech | Die Antwort wird zu gesprochener Sprache |
| Sehen | OpenAI Vision und Azure Computer Vision | Die Kamera erkennt Gesichter, Objekte und Gesten |
| Handeln | Misty HTTP-API | Misty führt Bewegungen, Navigation und Gesichtsausdrücke aus |
| Verketten | GPT-5, danach Claude Opus | Das zweite Modell prüft die Antwort des ersten |
Die Modellnamen entsprechen dem Stand dieses Beitrags.
Der Datenfluss
- 1Hören: Mistys Mikrofone nehmen Audio auf.
- 2Audio zu Text: Azure Speech-to-Text transkribiert in Echtzeit.
- 3Text zum Modell: Der Text geht mit Kontext an GPT-5 oder Claude Opus: Personen im Bild, aktuelle Position, bisheriger Gesprächsverlauf.
- 4Entscheidung: Das Modell liefert eine Antwort und Handlungsanweisungen im JSON-Format.
- 5Sprache: Azure Text-to-Speech wandelt die Antwort in Sprache um.
- 6Handlung: Bewegungsbefehle gehen über die HTTP-API an Misty.
- 7Emotion: Misty zeigt auf dem Display einen passenden Gesichtsausdruck.
Lärm: Spracherkennung an Messen und Anlässen
Mistys Mikrofone sind gut, aber an Messen und Anlässen ist es laut. Meine Lösung besteht aus vier Bausteinen:
- Noise Gate: Verarbeitet wird nur Audio über einem bestimmten Schwellenwert.
- Wake Word: Misty reagiert nur, wenn er direkt angesprochen wird.
- Verarbeitung in Abschnitten: Audio wird in Segmenten verarbeitet, nicht als Endlos-Stream.
- Nachfragen: Ist die Transkription unsicher, fragt Misty nach.
Latenz: Wartezeit, die natürlich wirkt
Der Weg vom Mikrofon über Speech-to-Text, das Sprachmodell und Text-to-Speech zurück zum Lautsprecher kostet Zeit. Meine Optimierungen:
- Streaming: Das Modell antwortet im Stream, die Sprachausgabe startet mit den ersten Wörtern.
- Caching: Häufige Begrüssungen und Standardantworten liegen lokal im Cache.
- Vorausladen: Während Misty spricht, wird die nächste mögliche Antwort bereits vorbereitet.
- Denk-Animationen: Misty zeigt «Denk-Animationen», damit die Wartezeit natürlich wirkt.
Autonomie: eine Zustandsmaschine mit sechs Zuständen
Das Schwierigste war weder die Spracherkennung noch das Sehen, sondern die autonome Entscheidungsfindung. Misty sollte nicht nur auf Befehle reagieren, sondern selbst entscheiden, was als Nächstes zu tun ist. Meine Lösung ist eine Zustandsmaschine, kombiniert mit Function Calling:
- Idle: Misty schaut sich um und reagiert auf Bewegung.
- Greeting: Jemand nähert sich, Misty begrüsst die Person.
- Conversation: Misty führt ein Gespräch mit einer Person.
- Guiding: Misty führt jemanden an einen Ort, etwa zu einem Meetingraum.
- Presenting: Misty hält eine Präsentation.
- Exploring: Ist niemand da, erkundet Misty selbstständig die Umgebung.
Die Zustände geben den Rahmen vor; GPT-5 entscheidet per Function Calling, welche Aktion Misty ausführt. Eine Antwort sieht zum Beispiel so aus:
// Beispiel einer Function-Calling-Antwort von GPT-5
{
  "action": "navigate_to",
  "target": "meeting_room_1",
  "speech": "Folgen Sie mir zum Meetingraum!",
  "emotion": "happy",
  "speed": "medium"
}
Zwei Modelle in einer Kette
Für diese Entscheidungen nutze ich LLM Chaining: Der Output des ersten Modells wird zum Input des zweiten.
- 1Kontext sammeln: Sensordaten, Gesprächsverlauf, Personen im Bild.
- 2Erstantwort: GPT-5 erzeugt Antwort und Handlungsanweisungen als JSON.
- 3Review: Claude Opus prüft die Antwort auf Sicherheit, Angemessenheit, Konsistenz und Tonalität.
- 4Ausgabe: Die geprüfte Antwort geht an Mistys Sprach- und Bewegungssystem.
Der Grund: Ein einzelnes Sprachmodell kann halluzinieren oder inkonsistent antworten. Ein zweites Modell eines anderen Anbieters prüft die Antwort, bevor Misty sie ausspricht oder ausführt. Diese Prüfung ergänzt feste technische Grenzen, ersetzt sie aber nicht (siehe «Grenzen» weiter unten).
Vier Sprachen
Misty versteht und spricht Deutsch, Englisch, Französisch und Italienisch, schliesslich sind wir in der Schweiz. Die Spracherkennung bestimmt die Sprache automatisch, und das Modell antwortet in derselben Sprache.
Was ich gelernt habe
Interaktionsdesign ist die grössere Aufgabe
Einen Roboter intelligent zu machen, ist nach meiner Einschätzung zu 30 Prozent Programmierung und zu 70 Prozent Design von Interaktionsmustern. Wie lange soll Misty warten, bevor er jemanden anspricht? Wie reagiert er, wenn jemand mitten im Gespräch weggeht? Was tut er, wenn er eine Frage nicht versteht? Das sind keine technischen Fragen, sondern UX-Fragen für die physische Welt.
Fehlertoleranz zählt bei Robotern mehr
Eine Software zeigt bei einem Fehler eine Meldung. Ein Roboter steht da und starrt Sie an, oder er sagt etwas Unsinniges. Graceful Degradation, also ein kontrolliertes Verhalten im Fehlerfall, ist bei Robotern deshalb noch wichtiger als bei Websites.
Sprachmodelle machen Robotik zugänglicher
Ohne die Modelle von OpenAI und Anthropic hätte ich Jahre gebraucht, um Misty natürliche Gespräche beizubringen. Mit GPT-5, Claude Opus und den Azure AI Services konnte ich das als Student ohne Robotik-Studium umsetzen.
Grenzen: Sicherheit und Datenschutz
Ein Prototyp wie Misty braucht feste Grenzen, bevor er mit Menschen interagiert:
- Modellausgaben nicht direkt ausführen. Eine feste Zustandsmaschine und eine kleine Liste erlaubter Aktionen sind die Basis. Ein Controller prüft und begrenzt jeden Parameter, bevor er einen Befehl ausführt. Bewegung braucht Geschwindigkeits- und Bereichsgrenzen, einen Not-Aus, Hindernistests und menschliche Aufsicht. Ein zweites Modell, das eine Antwort beurteilt, ist keine Sicherheitszertifizierung.
- Netzwerk kontrollieren. Laut Herstellerdokumentation verwendet Mistys HTTP-API keine Schlüssel oder Zugangsdaten: Jedes Gerät, das die IP-Adresse erreicht, kann Befehle senden. Der audiovisuelle Stream ist laut API-Dokumentation nicht verschlüsselt. Der Roboter gehört deshalb in ein kontrolliertes Netzwerk, ohne veröffentlichte API-Endpunkte und ohne Streaming von Gesprächen in ungesicherte Dienste.
- Gesichtsdaten schützen. Gesichtserkennung zur Identifikation ist bei Microsoft Face eine Limited-Access-Funktion und erfordert eine Freigabe. Biometrische Daten, die eine Person eindeutig identifizieren, gelten nach dem DSG als besonders schützenswerte Personendaten. Besucherinnen und Besucher wiederzuerkennen, setzt deshalb einen geprüften Zweck, eine Rechtsgrundlage, transparente Information, Einwilligung und technische Schutzmassnahmen voraus. Bei voraussichtlich hohem Risiko kann eine Datenschutz-Folgenabschätzung nötig sein.
- Demos datensparsam gestalten. Für Vorführungen eignen sich synthetische Inhalte, keine Speicherung von Gesichtern oder Gesprächsverläufen und sichtbare Hinweise, wenn Audio oder Video erfasst wird. Datenflüsse, Anbieter, Aufbewahrung, Löschung und Zugriffe sollten geklärt sein, bevor Personen mit dem Roboter interagieren.
Misty bei CNEXT
Aus der Studentenarbeit ist ein Teil unseres Embodied-AI-Angebots geworden. An Veranstaltungen und Messen zeigt Misty, was mit Azure AI Services und Sprachmodellen möglich ist, und er ist ein guter Einstieg in Gespräche. Mehr über das Angebot erfahren Sie auf unserer Embodied-AI-Seite, das Misty-Projekt finden Sie in unserer Projektübersicht.